从 Easy Dataset 到 LLaMA-Factory 青蟹微调实践
做青蟹大创时,我最开始关注的是怎么把训练跑起来,后来发现更费时间的是前面的数据:论文解析有没有漏表格,生成的问答是否保留实验条件,导出的字段和训练模板能不能对上。
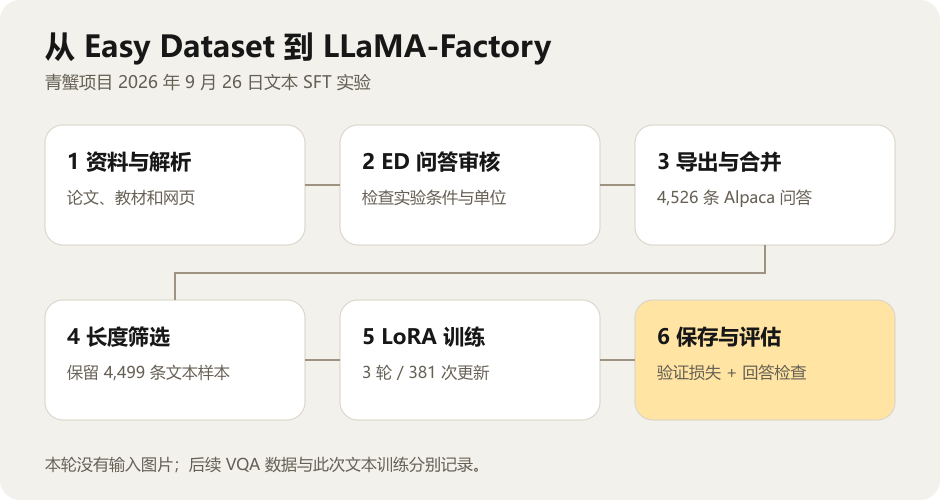
这篇把「修复 VQA 迁移问题」会话里的过程整理成一条路线:用 Easy Dataset 构建问答,审核后导出 Alpaca,统计真实 token 长度,再用 LLaMA-Factory 做 LoRA 训练。
主要数字来自 2026 年 9 月 26 日的实验快照:合并 4,526 条文本问答,长度筛选后保留 4,499 条,训练完成 3 轮、381 步。这轮使用 Qwen3-VL-8B-Instruct,但输入是纯文本;后续的图像 VQA 数据建设会在最后单独介绍。
1 在 ED 中先把资料整理成能追溯的样子
这里的 ED 指 Easy Dataset。我拿它管理青蟹相关论文、教材与网页资料,再从材料生成问答。它把资料处理、问答管理和训练数据导出放在一个界面里,适合先把自己的数据流程做明白。安装与支持的文件类型以 Easy Dataset 官方仓库为准。
一个实际可用的顺序是:新建项目 → 配置解析与生成模型 → 上传资料 → 检查解析文本与分块 → 生成问答 → 人工审核 → 导出。模型凭据放在自己的配置里,不要混进训练样本或导出说明。
上传前,我建议保留一个简单的来源台账:文件名、资料类型、题目或章节、年份、来源链接。正文里的出处并不能替代这份台账,因为后续合并、去重和按文档划分验证集都要靠它。
青蟹资料尤其要核对物种、发育阶段、盐度、温度和单位。解析结果里如果 mg/L、上标、表头或小数点错了,生成模型仍然可能写出非常顺的回答。因此,导入后的第一件事是对照原文检查重点段落和表格,再让模型生成问题。
问题要在独立阅读时成立。例如,单独的「为什么会这样?」丢掉原段落就无法回答;更好的问题应包含必要条件,明确讨论哪种现象、实验或比较。
2 生成问答以后,人工审核才是关键的一步
我不把生成完成视为数据完成。审核时同时打开原文和问答,检查答案是否真能从材料中得到,是否保留了结论成立的条件。
这类领域数据里,我会优先处理四种问题:数值或单位不一致;不同实验的结果拼在一起;同一个知识点大量换词重复;答案加入材料没有支持的因果或建议。只有题目改写,没有新增信息的样本,不值得一直堆数量。
系统提示与制数提示也要分开。像「生成十条问答」是给数据生成环节的要求,不应作为训练时每条样本的 system。训练 system 更适合约定:依据资料回答、保留条件和单位、证据不足时说明限制、不要编造具体数据。也不要把未指定的青蟹样本强行补成某一个物种。
刚开始做第一版基线时,我倾向于先用清楚的最终答案,减少复杂因素。实际 9 月 26 日这批数据保留了 <think>...</think> 内容,这会增加长度,也会进入训练目标。这里记录实际选择;以后若想比较有无这类内容,应分别制作版本,而不是训练到一半悄悄改数据。
3 导出 Alpaca,并确认字段真的对上
在当时的 ED 导出界面选择 JSON → Alpaca → instruction。各版本的界面名称可能变化,重点是最终 JSON 中字段的含义。
下面是结构示例,示例答案不代表实际训练样本:
[
  {
    "instruction": "在所给实验条件下,青蟹的盐度处理结果说明了什么?",
    "input": "必要的实验条件与资料摘录",
    "output": "根据资料作答,保留条件、单位与结论限制。",
    "system": "你是青蟹领域助手,依据资料回答,不编造数值。"
  }
]
instruction 放问题,input 放需要一起提供的上下文,没有就留空;output 是目标回答,system 是统一的角色和回答要求。导出后先检查 JSON 能否解析、问答是否为空、样本数量是否与确认的数据一致。
9 月 26 日,一份 ED 导出包含 2,471 条问答,约 7 MB;合并另一份 2,055 条后得到 4,526 条。合并记录检查了空问答、统一 system 和完全重复样本,原始数据保留。没有完全重复,不代表没有语义相近的问答,后面还需要按来源继续检查。
在 LLaMA-Factory 的 data/dataset_info.json 中增加数据集映射,保留原来其他条目。例如,筛选后使用的注册名是 scylla_paper_textbook_web_max2048:
{
  "scylla_paper_textbook_web_max2048": {
    "file_name": "scylla_paper_textbook_web_max2048/alpaca.json",
    "columns": {
      "prompt": "instruction",
      "query": "input",
      "response": "output",
      "system": "system"
    }
  }
}
这是需要合并到现有文件的一段配置,不要直接覆盖整个 dataset_info.json。列映射与支持的格式可查 LLaMA-Factory 数据准备文档。
4 长度按 token 算,还要带上真实模板
我原来很容易用「一条答案有多少字」判断长度,但模型真正处理的是 token,system、问题、回答和模板标记都会占位置。
当时使用模型自己的 tokenizer,配合 qwen3_vl_nothink 模板做统计。在已经准备好模型与注册数据的服务器环境中,执行:
cd /root/LLaMA-Factory
python scripts/stat_utils/length_cdf.py \
  --model_name_or_path /root/autodl-tmp/Qwen3-VL-8B-Instruct \
  --dataset scylla_paper_textbook_web \
  --dataset_dir /root/LLaMA-Factory/data \
  --template qwen3_vl_nothink \
  --interval 1024
这是当时安装版本中的统计脚本,换版本前检查脚本是否存在。模型目录必须真的包含配置、tokenizer 和权重,写一个目录名并不等于模型下载好了。
统计结果很直观:
| 长度条件 | 保留样本 | 占 4,526 条的比例 |
|---|---|---|
| 小于 2,048 token | 4,499 | 99.40% |
| 小于 4,096 token | 4,522 | 99.91% |
4096 比 2048 多保留 23 条。考虑首轮训练成本,我先用 2048 做基线,把不符合长度条件的 27 条完整样本另存。这样比直接截断长答案更容易检查,也保留了后续单独处理的余地。
项目用了自己的 filter_alpaca_length.py 做筛选,它不是所有 LLaMA-Factory 安装里都自带的脚本。复现时要按相同 tokenizer 和模板过滤,保留原始文件、筛选结果和排除清单。训练只选筛选后的注册名,不要把原始集和筛选集同时勾上,那会重复训练大部分样本。
5 在 LLaMA-Factory 中配置第一轮 LoRA
本轮基座是 Qwen3-VL-8B-Instruct。当时安装的 LLaMA-Factory 对应模板为 qwen3_vl_nothink,模型与模板需要配套。Qwen 的 Instruct 和 Thinking 是不同权重版本,选择一个模板或勾选开关,不会把 Instruct 权重变成 Thinking 权重。Qwen 官方模型卡
我用 WebUI 预览训练命令,核对数据集名、模型路径、输出目录和关键参数,再开始运行。下面是这次实验的配置要点:
| 参数 | 本轮设置 | 为什么关注它 |
|---|---|---|
| 训练阶段 / 方法 | SFT / LoRA | 先建立领域文本基线 |
| 精度 | BF16,无量化 | LoRA 本身不等于 QLoRA |
| cutoff_len | 2048 | 与前面的长度筛选一致 |
| learning_rate | 4e-5 | 记录基线学习率,便于后续比较 |
| lora_rank / alpha | 8 / 16 | 两者用途不同,不能混成学习率 |
| LoRA+ | 关闭 | 首轮先减少额外变量 |
| 单卡 batch / 梯度累积 | 4 / 8 | 有效批量约 32 |
| 轮数 / 预热步数 | 3 / 20 | 先观察三轮的验证表现 |
| 验证集 | 随机留出 10% | 跑通验证;正式评估需改进划分 |
| 日志 / 验证 / 保存间隔 | 5 / 100 / 100 步 | 有持续记录,也能比较检查点 |
| 输出目录 | /root/autodl-tmp/saves/scylla-text-lora-01 |
使用新的目录,结果放数据盘 |
视觉编码器和多模态投影层在这一轮保持冻结。训练入口与参数组织可参考 LLaMA-Factory SFT 文档;具体版本支持什么字段,以安装代码和 WebUI 预览结果为准。
有两个选项特别容易看错。LoRA alpha 16 是适配器缩放相关设置,LoRA+ 学习率比例 16 则会改变不同适配器参数组的学习率。当时服务器代码中,WebUI 将后者设为 0 才是关闭 LoRA+;预览命令应不再出现 --loraplus_lr_ratio 16。这条是当时版本的行为,不能拿 alpha 那一栏替代它。
另一个是 <think>:qwen3_vl_nothink 不会自动删除 JSON 中已经写入 output 的这些文本。是否保留,需要在数据阶段作决定,不能指望模板名称帮忙清洗。
6 381 步到底是怎么来的
4,499 条数据留出约 450 条验证,训练集约 4,049 条。单卡每小批 4 条,累积 8 次梯度,再更新一次参数:
有效批量 = 4 × 8 = 32
每轮更新次数 ≈ ceil(4049 / 32) = 127
3 轮 ≈ 127 × 3 = 381 步
所以 step 是参数更新次数;epoch 是完整遍历训练集的轮数,不能把它当成处理了多少条数据。最后一批不足 32 条,加上样本长度不同,实际处理量也不是每步都完全一样。
这一轮最终完成 381/381 步,正常结束并保存了 LoRA 适配器和检查点。记录里的验证损失是:
| 位置 | eval_loss |
|---|---|
| 第 100 步 | 1.18885 |
| 第 200 步 | 1.14348 |
| 第 300 步 | 1.12949 |
| 最终验证 | 1.12808 |
数值下降说明模型在这份验证数据上的预测损失降低,不能直接换算成「回答准确率提升多少」。当时配置也没有自动加载验证最好的检查点,保存完成之后仍需要比较。
第一次验证附近还出现过界面日志停住的情况。排查记录指向 WebUI 日志管道阻塞,修复后继续训练,没有重跑整轮。以后遇到进度不动,我会先看训练日志、进程与 GPU 状态,而不是马上认定是显存不足或直接重新开始。
7 想知道有没有变好,要换一种测试方式
从训练材料整理 100 道题做诊断,能看出格式、单位和常见知识点是否出问题,但它们不能算独立测试集。
下一轮我更想按整篇论文或教材章节留出资料:同一来源的相似问答尽量放在同一侧,减少随机切分带来的泄漏。比较基座与 LoRA 时,用相同问题、system 和采样设置,盲看答案,再记录事实正确性、条件完整性、数值单位和证据不足时的处理。
训练损失、验证损失、业务回答质量应该分别记录。这样后面换长度上限或加入图文数据,才知道到底改善了什么。
8 从文本 SFT 走到真正的 VQA
这轮用了 VL 基座,但没有给它真实图片,因此完成的是领域文本微调。后续在 ED 中制作 VQA 时,工作顺序变成:选择图片 → 对照图注和周边原文 → 生成依赖图片的问题 → 逐图审核 → 连同图像引用一起导出。
图像题不能只是把普通文本问答挂在图片旁边。科研图要核对坐标轴、单位、分组和显著性标记;照片则只能回答可见信息,不能凭一张模糊图片猜病原。不同面板与相邻图注匹配错了,也会把错误标注带进训练。每图生成 1~5 题是项目里的按信息量策略,不必为凑数量强行出题。
10 月 9 日的一个独立 VQA 批次最终审核确认 300 张图、647 条问答,过程中删掉了 6 条。这是后续数据建设记录,没有混入上述 9 月 26 日的 4,499 条文本训练。
真正做图文 SFT,还需要按框架支持的多模态格式配置图片路径与占位符,并检查服务器上的图片确实可读取。图片也会占上下文和显存,不能直接沿用纯文本长度统计的结论。多模态格式可查看前面的 LLaMA-Factory 数据文档。
下一阶段可以在同一基座上加载已有 LoRA 继续尝试图文训练,用新输出目录,同时保留一部分文本数据作对照。这是后续路线,本文记录里尚未用上述 VQA 批次完成这一步。
从这次过程看,我最该保留的不是一条很长的训练命令,而是资料来源、导出快照、长度分布、实际配置和验证结果。它们齐全,后面换模型或继续训练才有东西可比。
本文依据大创项目「修复 VQA 迁移问题」会话中 2026 年 9 月 23~26 日的数据与训练记录,以及 10 月 9 日的独立 VQA 审核记录整理。示例 JSON 使用占位内容,未公开原始训练数据和服务器凭据。