dpo工作流搭建
青蟹大创做到问答和检索之后,我开始考虑:同一个问题,模型可能都能写出一大段回答,但哪一种更值得学?回答更长、引用更多,就一定更好吗?
这次我先搭一条小流水线:从 Easy Dataset 取问题,固定 LightRAG 的证据,为每题生成三个候选,再交给人比较。本文整理的是 2026 年 10 月 9 日的小批测试:3 个问题、9 个候选答案、3 条 Argilla 记录。候选生成和展示已经跑通;当时人工提交数为 0,正式偏好对导出和 DPO 训练还没开始。
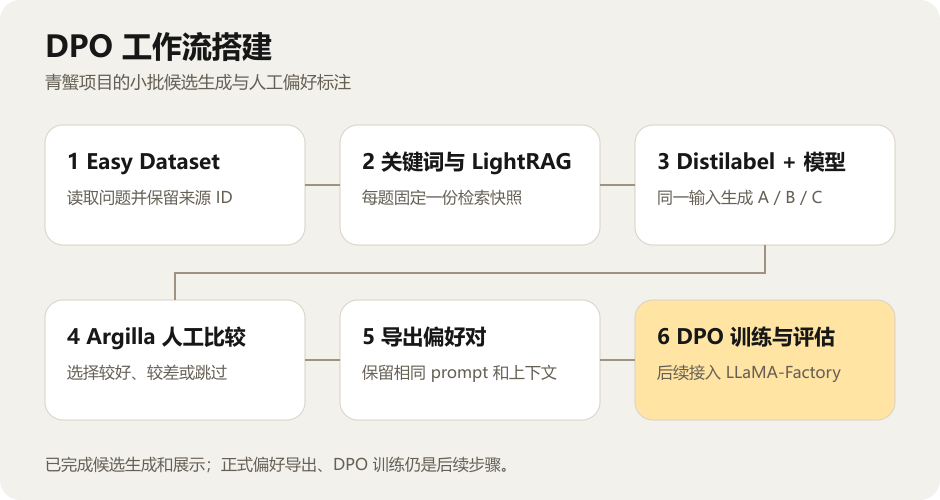
1 先弄清楚这条流水线要产出什么
DPO 需要的是同一个输入下的偏好回答对:prompt、chosen、rejected。有两个回答还不够,必须能解释为什么更偏好其中一个。DPO 的训练目标直接利用偏好数据,不要求像经典 RLHF 流程那样先单独训练奖励模型。原理可读 DPO 论文。
所以我把这次的终点先设为「人能够看到并比较候选」,而不是「自动生成一批高质量 DPO 数据」。青蟹问题常带实验条件,盐度、发育阶段、饲料配方少一个,结论就可能变样。自动挑最长的答案,很容易把说得最满的那个挑进去。
2 工具各自负责哪一段
我已有 Easy Dataset 和 LightRAG,这次新增的是生成编排和标注界面。
| 工具 | 在本次流程中的用途 |
|---|---|
| Easy Dataset | 提供已有问题,保留问题 ID 和来源线索 |
| LightRAG | 为问题检索证据,保存本次检索快照 |
| Distilabel | 编排候选生成,承接模型调用与中间结果 |
| Argilla | 展示问题、证据和 A/B/C,供人工比较 |
| LLaMA-Factory | 后续接收确认后的偏好数据进行训练 |
本地记录使用 Distilabel 1.5.3、Argilla 2.8.0;Argilla 放在 WSL 的服务环境中,数据落在 E 盘,网页入口绑定本机的 6900 端口。这是当时的环境快照,不是所有人都必须照抄的版本组合。Distilabel 快速入门介绍了它的流水线和缓存机制。
3 每题先固定证据,再生成三个回答
测试选了盐度、蜕壳和饲料相关的三个真实问题。每题的顺序是:提取检索关键词 → 获取证据 → 组成最终 prompt → 生成 A/B/C。
这里我最在意的是三个候选使用相同的输入。如果 A 看了论文甲,B 看了论文乙,最后选 A,究竟是在选回答能力,还是选检索结果?因此,同题共用一份证据快照和同一个 prompt,并记录 prompt hash。
当时自己的 SFT 模型还没有接入,先用 deepseek-flash 作为生成端跑通流程。关闭思考模式,温度 0.8,每个候选最多输出 4096 token。同一问题独立生成三次,让回答有一定差异;这些设置用于小批测试,不代表已经找到了最优采样参数。
LightRAG 原来的关键词模型额度耗尽后,我把关键词提取放到外部步骤,再将高、低层关键词传给检索。原有图谱和全局配置保留,Jina embedding 与 reranker 继续使用。测试中的检索参数为 mix、top_k=12、chunk_top_k=6、启用 rerank;这些参数需要随资料和问题调整。LightRAG 官方仓库提供检索与服务配置说明。
这批一共调用生成模型 12 次:3 次关键词提取 + 9 次候选生成。如果关闭 RAG,流水线跳过关键词和检索步骤,但不应删除历史快照,方便之后对比。
4 中间结果落盘,失败以后才能接着跑
我没有把问题、证据和回答只留在控制台里。每题单独保存关键词、证据、三个候选及比较信息,生成成功后立即落盘。这样后面 Argilla 出问题,或者某题超时,可以只补失败的部分。
项目中的实际命令是:
python candidate_pipeline.py \
  --input data/ed3-flash-20261009/questions.json \
  --output data/ed3-flash-20261009/run \
  --publish scylla-ed3-flash-candidates-20261009
candidate_pipeline.py 是本项目的脚本,不是安装 Distilabel 后就自带的命令。它依赖项目配置与环境变量中的模型凭据,使用前要先准备对应输入文件。
这次专门检查了两件事:重复跑已完成的批次不会新增模型调用;重复发布到 Argilla 新增记录数为 0,仍然保持 3 条。人工填写过的内容也不应被重发覆盖。这样的验证,比看到一次「运行成功」更能说明后面可以续做。
5 人工比较时看什么
Argilla 里每条记录同时展示问题、证据和三个答案。标注时先看证据是否真的回答了问题,再比较事实、条件、单位和表达。它的标注有提交与草稿等状态,界面里出现记录不等于标注已经完成。Argilla 标注说明
我给自己的比较顺序是:
- 回答有没有擅自补物种、阶段或实验条件?
- 数值与单位能否在证据里找到,是否混用了不同实验?
- 有没有把相关性写成因果,或把一个研究的结果推广为普遍规律?
- 在正确的前提下,哪个回答更直接、更能说明依据和限制?
比如 C2 与 C5 阶段的结果,不应该只因为都谈盐度就直接放到一张比较表里;「该研究表明」也需要能指向具体来源。关键词自动补成某一种青蟹时,还要检查原问题是否真的指定了该物种。
如果三个答案都错、基本相同,或者证据不足,就跳过这题。生成了三个候选,并不保证存在值得训练的偏好差异。
6 导出偏好对时,别丢掉原来的输入
后续导出应使用实际参与比较的完整 prompt,包含一致的系统要求、问题和证据,不能训练时才偷偷加另一份检索内容。
下面只是结构示例,文字是占位符,不是本批次已提交的偏好对:
{
  "instruction": "问题与本次固定的检索证据",
  "input": "",
  "chosen": "人工确认更好的回答",
  "rejected": "人工确认较差的回答"
}
若使用 LLaMA-Factory,还要在 dataset_info.json 中声明偏好数据的 ranking 和列映射,按它的数据准备文档对接。把 RAG 回答自动标成 chosen、无检索回答自动标成 rejected,会把「用了检索」误当成质量标签,我没有这样做。
7 三题小测实际验证了什么
9 个候选均非空、正常结束,同题没有完全重复的三个答案,输入和证据保持一致。它验证了流程连通和基本输出完整性,尚未证明回答质量提升。
生成接口记录了 127,201 个输入 token、8,337 个输出 token;其中输入缓存命中 83,692,未命中 43,509。按 10 月 9 日测试时记录的价格口径,低峰模型费用估算约 0.08 元,高峰口径约 0.16 元。这是 token 记录推算,不是平台最终账单,且不含 Jina 检索相关费用。
对我来说,这次最有用的收获是把一次模型调用拆成可以检查的几个环节。下一步先提交人工比较,再检查偏好对分布与来源覆盖,最后才做 DPO 训练。三题规模很小,但至少能在扩大批量以前发现:输入是否一致、失败能否续跑、标注有没有被重复发布覆盖。
本文依据青蟹项目 2026 年 10 月 9 日的 DPO 会话、配置、三题使用说明与运行记录整理。