LightRAG 使用指南 从青蟹论文到可溯源问答
做青蟹相关的大创项目时,资料很容易越攒越多:一篇论文讲蜕壳,一篇讲盐度,还有教材、网页和数据集说明。查一个问题,往往要在好几个 PDF 里反复搜索。
我想让这些资料能按问题检索,也能沿着物种、环境因素和实验指标之间的关系继续查。于是,项目里引入了 LightRAG,并在后来的 CrabGraph 工作台里接入它的检索结果。这篇文章从本地部署讲起,重点记录入库、检索、限流和来源核对中比较有用的经验。
如果你也在做课程设计或大创,可以先拿几篇自己的论文走完这个流程,再考虑扩大知识库。
1 先理解资料如何变成回答
LightRAG 会从文本中抽取实体与关系,同时建立向量索引。查询时,它可以结合图谱线索和原文片段组织上下文。比如青蟹资料中的物种、盐度、蜕壳阶段,都可以成为检索的入口。基本机制可参考 LightRAG 官方仓库。
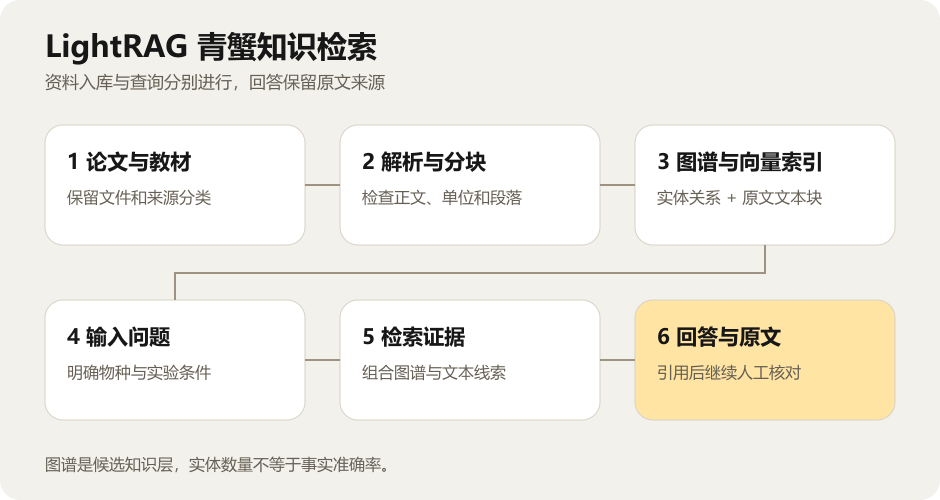
这里最值得关注的是最后一步:回答里的结论,能不能回到原文核对? 图谱上的一条关系是模型抽取的候选信息。写实验方案或论文时,还要检查它对应的物种、数值、单位和实验条件。
青蟹项目尤其需要区分物种。例如,Scylla paramamosain 和 Scylla serrata 属于不同物种,检索到后者的研究,不能直接当作前者的实验结论。项目方案里专门保留了这条质量规则。
2 在 Windows 上跑通一个新知识库
下面演示在新目录安装官方源码版,不覆盖已有知识库。准备好 Git、Python 和 Bun;当前官方项目要求 Python 3.10 及以上,这里使用 Python 3.11。依赖要求见 项目配置,安装流程见 官方服务器指南。
在 PowerShell 中执行:
Set-Location E:\
git clone https://github.com/HKUDS/LightRAG.git LightRAG-demo
Set-Location .\LightRAG-demo

py -3.11 -m venv .venv
.\.venv\Scripts\python.exe -m pip install -e ".[api]"

Set-Location .\lightrag_webui
bun install --frozen-lockfile
bun run build
Set-Location ..

Copy-Item .\env.example .\.env
接着编辑 .env。下面是基础示例,模型名、服务地址和密钥需要换成自己实际使用的配置:
HOST=127.0.0.1
PORT=9621
WORKERS=1

LLM_BINDING=openai
LLM_MODEL=你的对话模型名称
LLM_BINDING_HOST=https://你的服务商地址/v1
LLM_BINDING_API_KEY=你的对话模型密钥

EMBEDDING_BINDING=jina
EMBEDDING_BINDING_HOST=https://api.jina.ai/v1/embeddings
EMBEDDING_MODEL=jina-embeddings-v5-text-small
EMBEDDING_BINDING_API_KEY=你的Jina密钥
EMBEDDING_DIM=1024
EMBEDDING_TOKEN_LIMIT=8192
EMBEDDING_ASYMMETRIC=true
EMBEDDING_FUNC_MAX_ASYNC=1
EMBEDDING_BATCH_NUM=8
Jina 这一组来自青蟹项目的配置记录,实际返回维度曾验证为 1024。换服务商时,必须先确认其模型名称、输出维度和检索任务参数,不能只替换 API 地址。
启动服务:
$env:PYTHONUTF8 = '1'
$env:PYTHONIOENCODING = 'utf-8'
.\.venv\Scripts\lightrag-server.exe
然后打开 http://127.0.0.1:9621/webui/。另开一个终端检查服务:
Invoke-RestMethod 'http://127.0.0.1:9621/health'
青蟹项目在 9 月的安装记录中使用了 1.5.8,并保留了一些本地补丁。上面的命令会获取官方当前源码;后文的项目改造不能假定已经包含在新安装版本中。复现实验时,应记录源码提交号、依赖版本和模型配置。
对话模型和 Embedding 要分开看
对话模型负责抽取、整理和生成文字,Embedding 负责把文本编码成用于检索的向量。项目中的 Jina 配置把文档编码为 retrieval.passage,把问题编码为 retrieval.query,并保持查询与入库配置一致。
即使两个模型都输出 1024 维,生成的向量也不一定兼容。 要更换 Embedding 模型、维度或非对称编码方式,先备份,再在独立知识库里重新索引。已有向量不能直接拿来和新编码的问题比较。具体规则见 非对称嵌入配置。
LightRAG 还支持按任务分配模型:
| 角色 | 在项目中承担的任务 |
|---|---|
EXTRACT |
入库时抽取实体、关系并整理描述 |
KEYWORD |
从问题中提取检索关键词 |
QUERY |
根据检索上下文生成最终回答 |
VLM |
分析输入文档中的图片 |
先用一套基础配置跑通,再分别调整角色,会更容易定位问题。抽取任务会对多个文本块反复执行,耗时和费用都值得单独观察。角色变量的写法见 官方角色配置指南。
3 导入论文前先检查资料
青蟹项目在 2026 年 9 月 17 日整理了 208 份 PDF,共 5543 页:116 份论文、78 份网页资料、11 份教材和 3 份数据集资料。它们是整理好的输入资料,不代表全部已经成功入库。
整理时采用的顺序是:有原始 PDF 就保留原件;没有原件时追溯来源;仍找不到时,才把已有 Markdown、图片和来源信息渲染成自包含 PDF。论文、网页和教材保留各自的来源分类,方便后续判断证据性质。
首次入库,我建议按下面的顺序操作:
- 选 3~5 篇正文能正常提取的短论文,尽量围绕同一个主题。
- 在 WebUI 文档管理中上传,等待处理结束,查看成功、失败和进行中的记录。
- 检查解析后的正文:双栏阅读顺序是否错乱,表格单位是否保留,图注有没有混进正文。
- 用论文中一个容易人工确认的问题做检索,核对召回片段和原始文件。
- 小样本通过后再分批增加资料,整本教材单独处理。
扫描版 PDF 要先解决 OCR 或解析问题。只提取到图注,也不能说明系统已经理解了图中的青蟹形态。正文、表格和图片应分别检查,尤其是后续要用于蜕壳判断或实验设计的内容。
项目在 9 月 26 日的记录是 42 条文档记录,其中 38 条 processed、4 条 failed。这组数字提醒我,验收要看文档状态和可用证据,不能只看上传是否返回成功。
4 用同一个问题比较检索模式
常用模式可以这样理解:
| 模式 | 主要检索线索 | 青蟹项目中的练习问题 |
|---|---|---|
naive |
原文文本块的向量相似度 | 查某篇论文中的实验条件 |
local |
具体实体及其相关信息 | 查某个物种或指标 |
global |
主题相关的关系信息 | 梳理环境因素与生长的联系 |
hybrid |
合并 local 与 global | 同时查对象和相关关系 |
mix |
图谱检索加文本块检索 | 作为综合问答的起点 |
这些模式的定义见 官方查询模式说明。表中的问题是练习方向,能否回答仍取决于知识库里的资料。
可以拿下面这个问题,分别试一次 naive 和 mix:
资料中有哪些关于拟穴青蟹蜕壳与盐度关系的研究?请分别列出物种、实验阶段、盐度单位和原文出处;缺失的条件不要补写。
比较时,我会看有没有召回目标物种的论文、有没有带出相关原文,以及回答是否保留了实验条件。文字更长、图谱节点更多,都不能单独证明检索更好。
接入自己的应用时先取检索数据
CrabGraph 使用 /query/data 获取实体、关系、文本块和来源,再交给自己的回答流程。这个接口适合先检查“找到了什么”,再排查“回答为什么写成这样”。
下面是 PowerShell 示例。9621 对应前面新建的演示实例;项目里的独立副本使用 9622,调用时要确认自己连接的是哪个知识库。
$queryPayload = @{
    query = '拟穴青蟹蜕壳与盐度关系有哪些研究证据?'
    mode = 'mix'
    top_k = 12
    chunk_top_k = 8
    max_total_tokens = 14000
    max_entity_tokens = 2000
    max_relation_tokens = 2000
    enable_rerank = $false
} | ConvertTo-Json

$queryHeaders = @{}
if ($env:LIGHTRAG_API_KEY) {
    $queryHeaders['X-API-Key'] = $env:LIGHTRAG_API_KEY
}

$queryResult = Invoke-RestMethod `
    -Uri 'http://127.0.0.1:9621/query/data' `
    -Method Post `
    -Headers $queryHeaders `
    -ContentType 'application/json; charset=utf-8' `
    -Body ([System.Text.Encoding]::UTF8.GetBytes($queryPayload))

$queryResult.status
$queryResult.data.chunks
$queryResult.data.references
这些数值沿用了工作台的检索配置,适合作为起点。top_k 控制候选实体或关系数量,chunk_top_k 控制候选文本块数量;最终上下文还受 Token 预算等参数约束。不要把候选数量理解成最终必定返回的证据条数。
/query/data 不生成最终回答,但关键词提取和 Embedding 等步骤仍可能调用模型并产生费用。先用少量问题检查 chunks 与 references,比连续生成完整答案更方便定位检索问题。工作台接入方式可以查看 CrabGraph 的检索实现。
5 Jina 返回 429 时先看限制类型
9 月 17 日的一次入库日志里,Jina 报出 114134 / 100000 tokens per minute。这次触发的是每分钟 Token 限制,后续共享向量落盘失败,13 份恢复中的文档被连带取消。
这个坑让我注意到:并发数限制的是同时发多少请求,TPM 限制的是一段时间里发多少 Token。 即使并发只有 1,一条请求带很多文本,仍可能超过限制。少传几个文件方便观察,但不能代替 Token 预算控制。
项目中增加了本地 Jina Embedding 限流器,让文本块、实体和关系的向量请求共享预算。当时设置的是:
# 青蟹项目本地补丁的参数,并非通用官方配置
JINA_EMBEDDING_TPM=70000
JINA_EMBEDDING_RPM=60
JINA_EMBEDDING_WINDOW_SECONDS=65
限流器采用 65 秒窗口,以 70000 Token 的预算留出余量;收到 429 时进入共享冷却,并尊重更长的 Retry-After。日志里的 local rate limit: waiting 可能只是主动等待。
这组配置只协调单进程内的 Embedding 请求,所以当时保留 WORKERS=1。它不会统管其他程序使用同一个 Key 的请求,也不包含 Reranker 的 Token 用量。仅把这些变量复制到没有补丁的官方安装中,并不会得到同样的限流功能。
排错时还要区分 401 鉴权失败、网络连接失败和额度不足。看到 429 后,先读响应内容和日志里的限制名称,再调整请求;不要连续点击批量重试,让失败记录和费用一起增加。
6 长篇教材需要可恢复的处理过程
短论文可以处理,整本教材却失败时,我会先检查失败阶段和单次工作量。单纯增大超时,无法解决所有问题。
9 月 22 日,项目里给长文档处理增加了分片和恢复机制:超过 120 个原始文本块的文档自动分片,每片最多 32 个块、96000 字符。这里的字符上限与 API 的 Token 限制是两回事。
它是在已有文本块上分组,优先保留章节和段落边界;原 PDF、父文档 ID、来源以及原始 chunk ID 保持不变。已提交的片段可以跳过,中断片段依靠落盘日志和缓存恢复。只有全部存储提交结束,父文档才能标记为 processed。
这属于项目改造,不是安装官方 LightRAG 后就能照搬的默认功能。9 月 22 日的专项回归有 157 项通过,改造代码也已重启加载;当日记录中的目标长文档仍未完成正式恢复。测试通过和真实文档完成,需要分别验收。
自己处理长文档时,建议保留文档 ID、失败阶段和日志,确认哪些部分已经提交,再执行受支持的恢复操作。不要手改状态把 failed 变成 processed,也不要一遇到失败就清空图谱。否则表面状态变好了,来源和存储却可能对不上。
7 把来源接进工作台并做好迁移
后续的 CrabGraph 工作台接入了 LightRAG 的独立副本:原实例使用 9621,副本使用 9622,存储目录也分开。迁移时核对了 GraphML 文件的 SHA256,而不是只确认网页能打开。
2026 年 10 月 10 日的校验记录中,原图谱与副本均有 26191 个节点、27790 条边。这是已存储图谱的规模,不是人工审核后的事实数量,也不代表检索准确率。网页一次只画出几十或几百个节点,也可能是显示上限造成的。
接入回答流程时,工作台保留原文块和文件来源,按“来源路径 + chunk ID”去重,再生成 S1、S2 这样的引用编号。回答里出现不在证据列表中的编号,会被替换为“来源待核实”。
这只能检查编号是否存在。一个合法的 [S1],仍可能没有支持句子中的结论。 对青蟹项目,我会继续核对物种、实验阶段、数值、单位和处理条件;图谱描述与原文冲突时,回到原始论文确认。
迁移到服务器前,可以按这个顺序准备:
- 等待当前写入结束,备份源码版本、依赖记录、原始资料和完整存储;密钥单独配置。
- 为服务器建立独立目录,保持 Embedding 模型、维度和编码方式一致。
- 恢复后核对文件哈希、文档状态和图谱规模,再用固定问题比较来源片段。
- 开放网络访问前配置鉴权,并检查 API 路径的认证范围,具体变量见 官方配置样例。
我现在更愿意把验收问题写得具体一点:检索到了哪篇论文,引用了哪个片段,这个片段讨论的是哪种青蟹。做到这一步,LightRAG 才真正帮我减少了翻资料的工作,也方便在答辩时解释一个结论从哪里来。