Random Forest、Adaboost、GBDT
同步自我的 CSDN 原文:Random Forest、Adaboost、GBDT。原文更新时间:2025-11-19 01:10:25。保留原文内容与代码,配图已保存到本站。
一、集成学习
将多个弱监督模型组合,突破单个算法的上限,以产生更好的效果(降低预测的偏差或者方差)。常见的集成学习框架有三种:Bagging,Boosting 和 Stacking
注:本文介绍的所有算法的学习器皆由CART决策树实现
1.1Bagging
并联
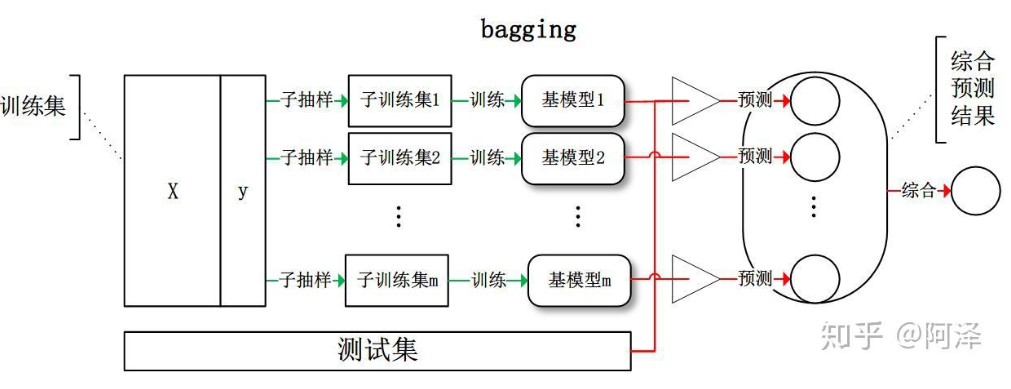
将训练集有放回的随机抽样,产生多个子训练集,分别训练模型,综合考虑结果
1.2Boosting
级联
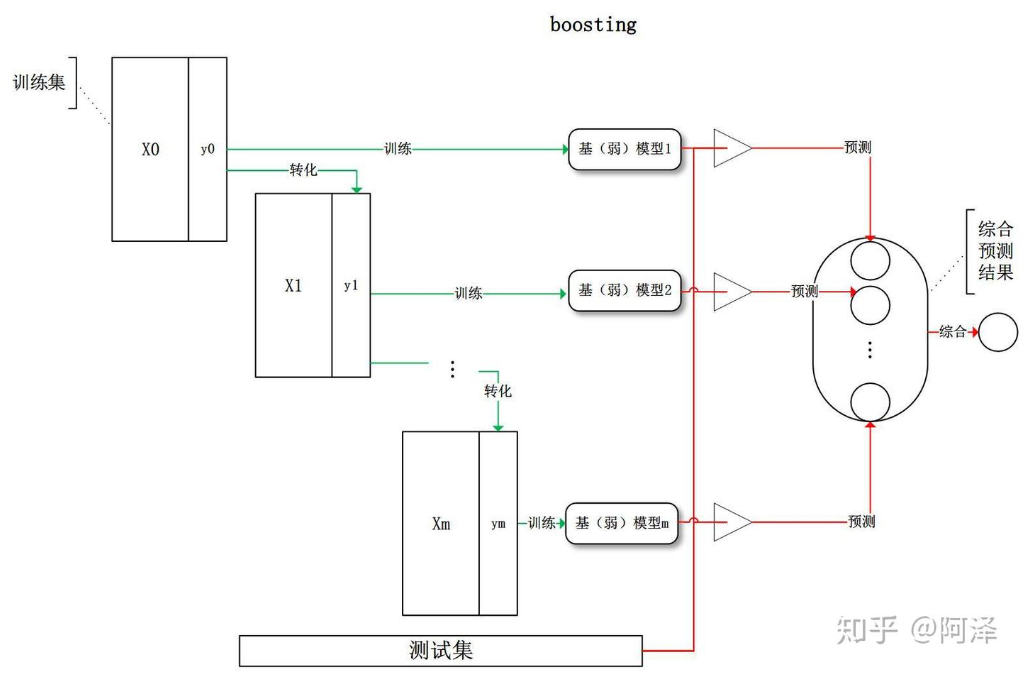
不随机抽样直接用整个训练集,不断迭代子模型
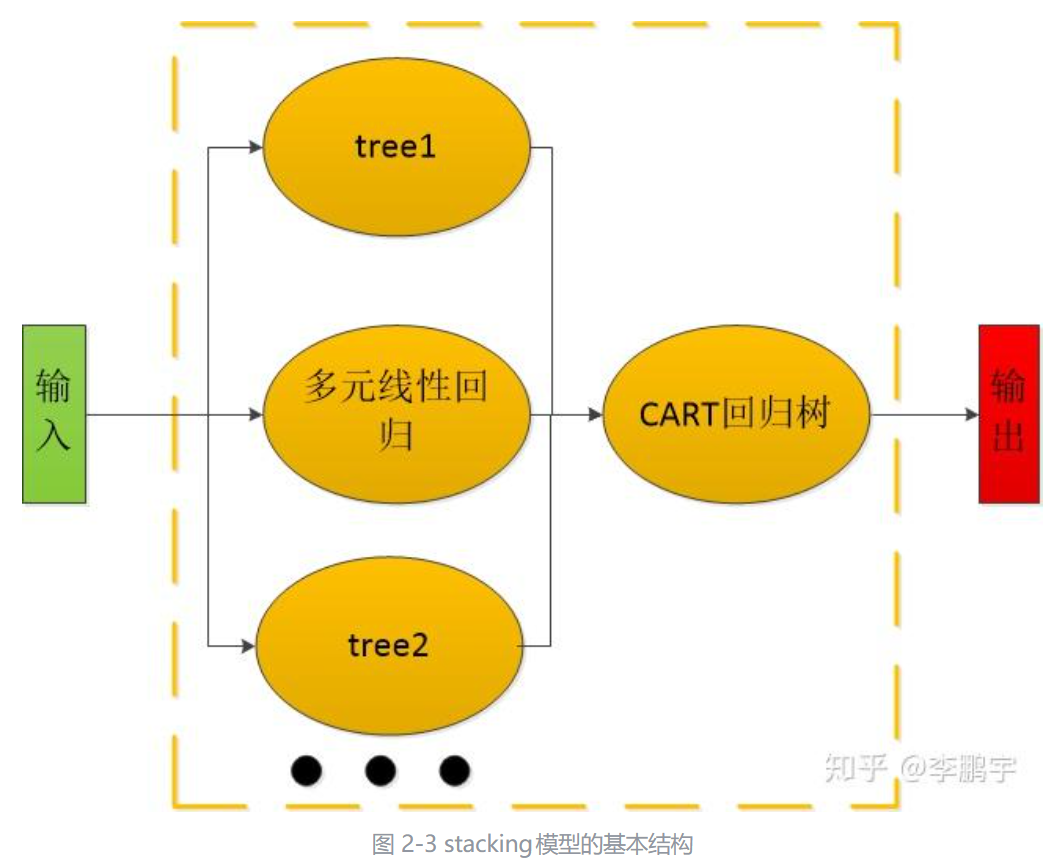
1.3 Stacking
相比bagging模型
- 允许使用不同类型的模型作为base model
- 使用一个机器学习模型把所有base model的输出汇总起来(加权求和),形成最终的输出
1.4 残差
残差 = 真实值 – 预测值
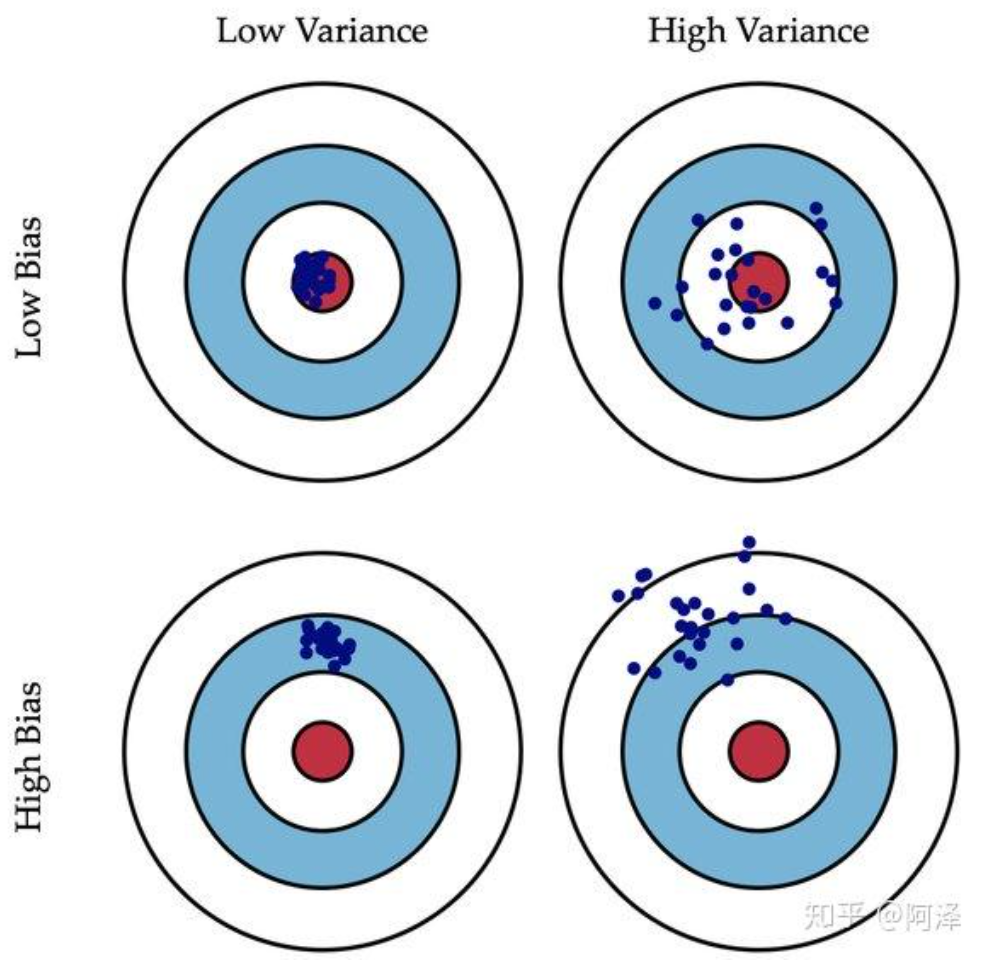
评价一个模型的预测能力,一般考察残差的两个方面
- 偏差,即与真实值分布的偏差大小
- 方差,体现模型预测能力的稳定性
前提: 无论bagging还是boosting,基分类器在方差和偏差方面都很弱
但将多个基分类器组合在一起时
- Bagging:由于随机抽样,增加了随机性,将多个高方差模型的结果进行平均,从而显著降低整体模型的方差
- Boosting:由于整个迭代过程使用了同样的数据集,可以不断调整模型对数据的偏向性,从而显著降低整体模型的偏差
二、随机森林
bagging类型
随机: 随机抽样
森林: 随机样本训练出的多个决策树组合
2.1训练步骤:
-
分几棵树,每棵树分几层
-
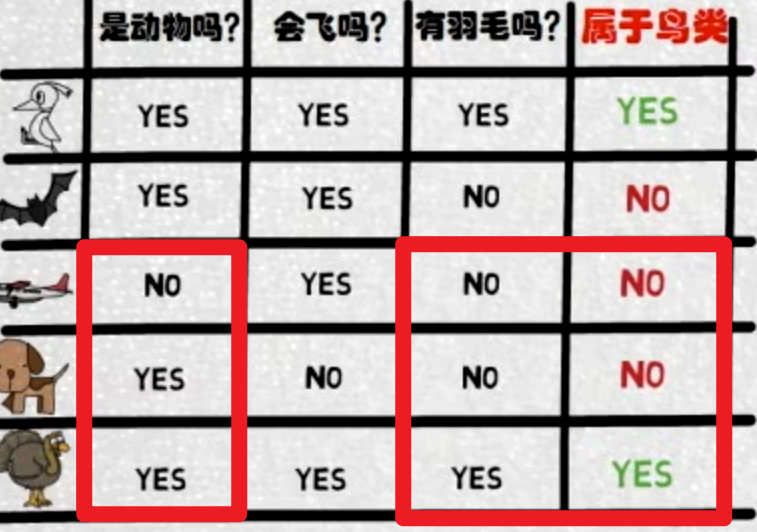
随机采样,训练每个决策树
DATASET[N * D] => data subset[n * d]
N,n 样本数量,N > n
D,d 特征数量,D > d
-
聚合
Regression:均值
Classification:众数
2.2 优缺点:
pros:
- 随机抽样(随机性强),具有很强的抗噪性(可以避免异常数据的影响)低方差
- 并联同时训练 +随机抽样成小样本,处理高维数据更快
- 树状结构,模型解释性强,每个特征的重要性
cons:
- 不具备处理困难样本的能力,弱分类器 + 相互独立,导致每一个分类器都无法处理困难样本
三、Adaboost
boosting类型,弱分类器
3.1 训练步骤
-
分几棵树,每棵树分几层
-
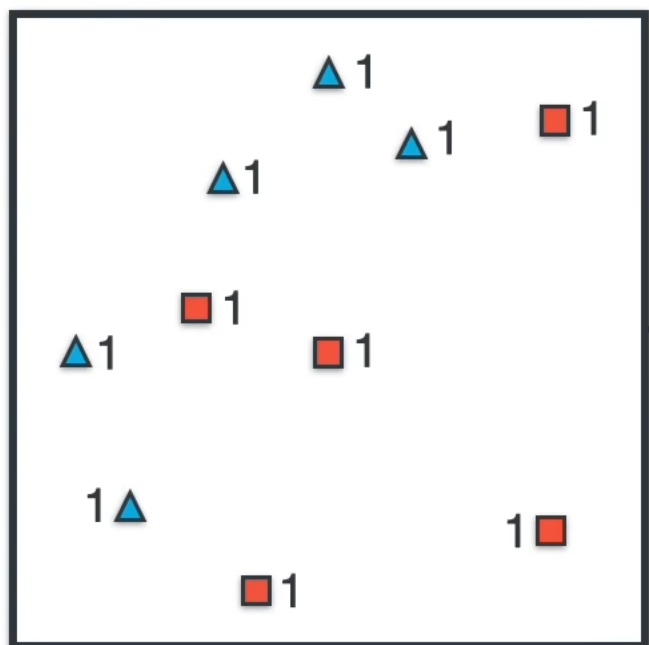
初始化每一个样本点困难度为1
-
利用当前分类器的训练结果,更新所有样本的困难度
提高错误样本的困难度,正确样本困难度不变
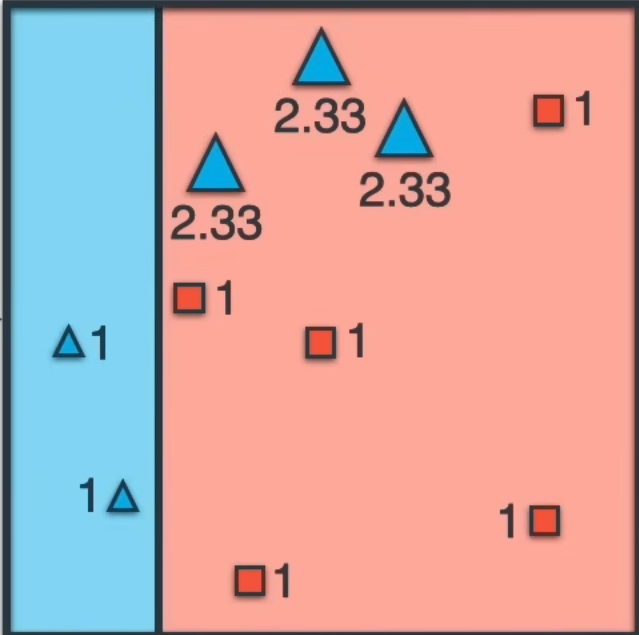
正确/错误 = 7/3,将每一个错误点放大三分之七,与正确总权重齐平
-
基于当前困难度,训练下一个分类器
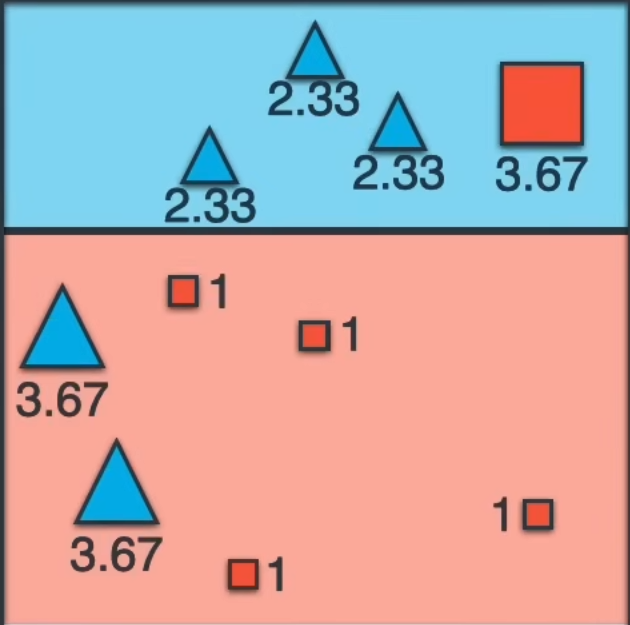
可以看到,上一轮的错误点因为被重点关照(提高权重),使得正确分类,但出现新的错误
正确/错误 = 11/3,将每一个错误点放大三分十一,与正确总权重齐平
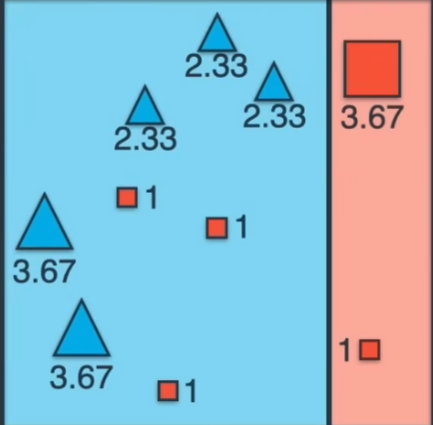
正确/错误 = 19/3,将每一个错误点放大三分十一,与正确总权重齐平
-
聚合,根据每个分类器的正确率,分配对应的权重(一般越靠后权重越高)
注意:我们不能直接使用正确/错误来模拟正确率
对比第三个分类器,假设有一个学习器的比值是正确/错误 = 3/19,认为对它的奖励变为惩罚,但其的惩罚力度与第三个分类器的奖励力度并不相等
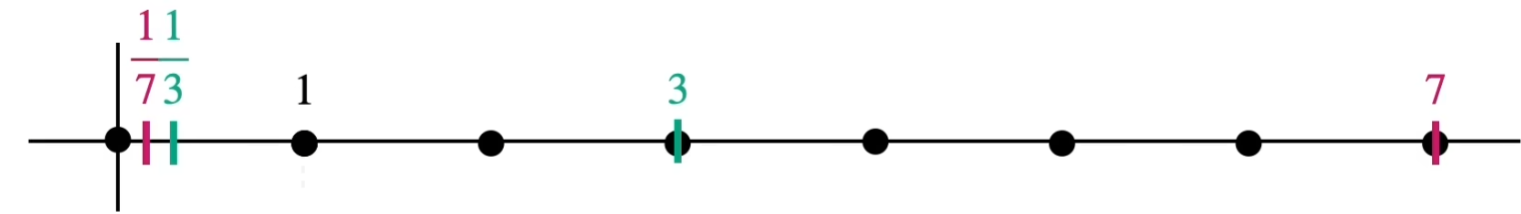
正确做法:取对数作为权重
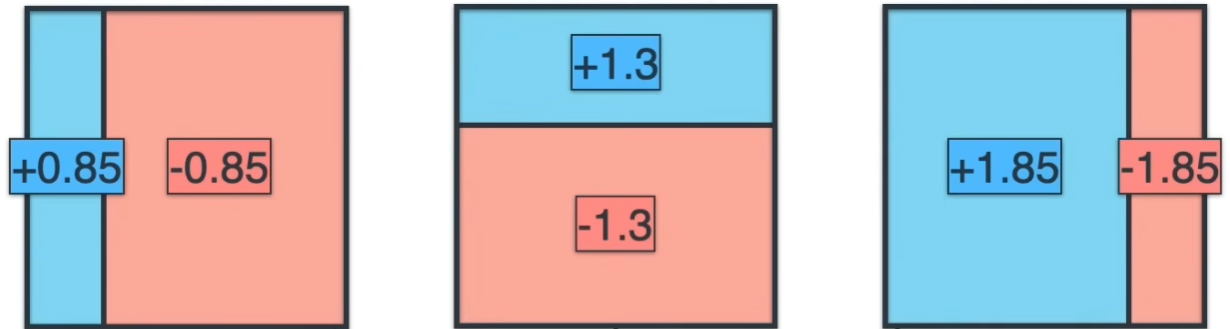
- 按权重聚合
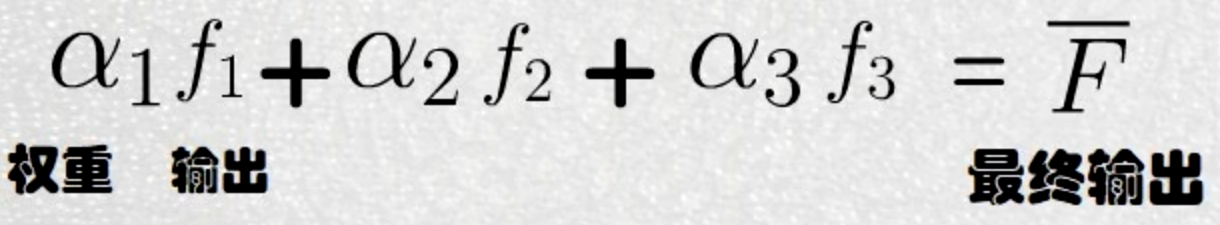
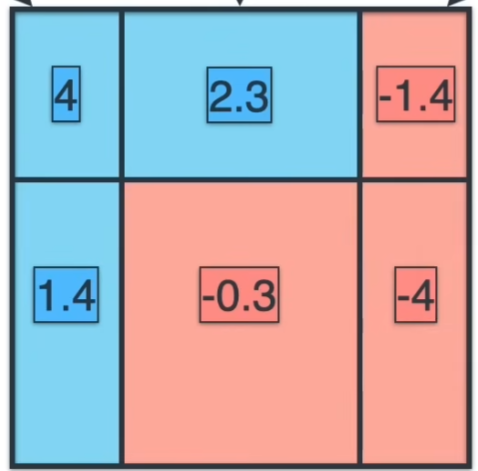
一般不可能会有0
3.2优缺点
pros:
- 级联结构不断迭代 + 利用权重组合结果,可以处理困难问题
cons:
- 专注于处理困难问题,会导致对异常数据过于敏感,高方差
- 级联训练,前一个训练好才能训练下一个,训练速度慢
四、Gradient Boosting
boosting类型,与Adaboost 的区别在于迭代和聚合
- 通过调整错分数据点的权重来改进模型
- 通过计算负梯度(向极小值逼近的方向)来改进模型
残差:真实值与预测值的差
上一轮预测结果的残差作为当前的 训练数据 集的真实标签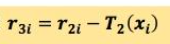
梯度下降: 对目标进行极小化,直到收敛
由于负梯度方向是函数值下降最快的方向,故可以将损失函数的值不断缩小。
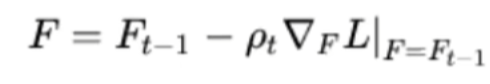
回归: 均方差损失函数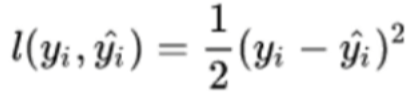
负梯度计算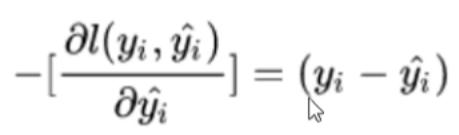 ,结果正好是残差,故用负梯度近似模拟残差
原理是残差,但实际算法中是不断及计算梯度来更新模型的
分类: 交叉熵损失函数
-
二分类:
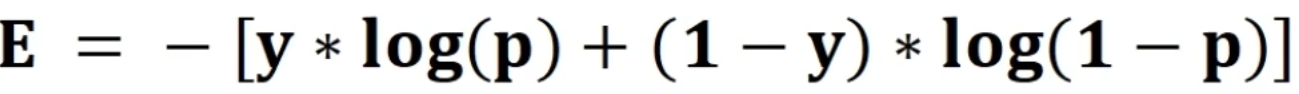
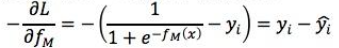
-
多分类:
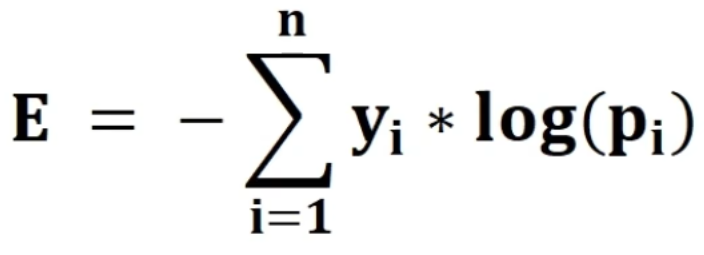
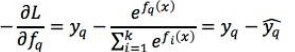
注: 一般 分类模型 给出的都是每个类别的概率,而不是确切的类别
4.1 训练步骤
- 分几棵树,每棵树分几层
- 初始化弱学习器,将样本标签的均值做为预测值,得到初始学习器
- 迭代每一棵树
- 对于每个样本计算负梯度(残差)
- 将上一步计算的残差作为样本的新真实值
- 训练第2棵树来拟合残差(cart回归树)
- 用残差更新强学习器,设置学习率,计算损失函数的值
- 重复,直到无法优化
- 将每一个学习器的结果相加
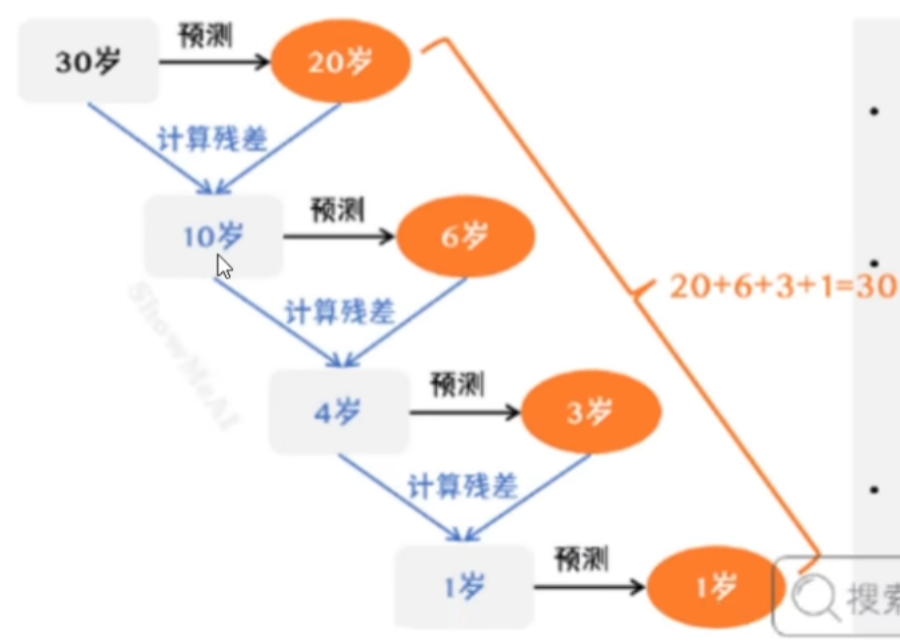
梯度下降与残差:仅按照我的理解
残差是算法的思路,梯度下降是实际计算时使用的方法,得益于损失函数便于计算,故梯度模拟残差
4.2复杂的例子
4.3 优缺点
pros:
- 非常灵活,可选的损失函数非常多,并且可以处理连续或离散的数据(CART树)
- 相对adaboost,异常样本权重不易被提升,对异常值不敏感
cons(boosting限制):
- 串行生成,速度慢
- 数据维度高,计算复杂度高
4.4 GBDT的演化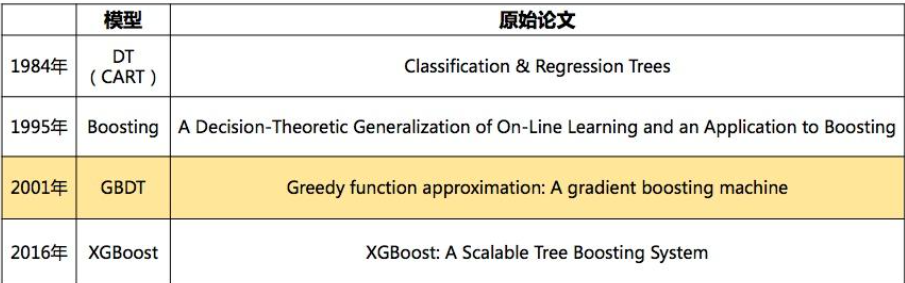
五、偏差和方差方面的分析
5.1 RandomForest
- 随机森林引入随机子采样,将多个高方差模型的结果进行平均,可以显著降低整体模型的方差
- 每一个分类器各自独立,都具有各自的偏向性,无法显著降低偏差
5.2 Adaboost
- 对异常数据过于敏感,容易引起过拟合,高方差
- 不断迭代分类器意味着不断优化偏差
5.3 Gradient Boosting
- 通过残差拟合/梯度下降机制,GBDT 在降低偏差方面能力极强,通常优于 AdaBoost
- 学习率的设置使得模型稳步更新、GBDT 的实现(如 XGBoost)引入了大量正则化手段来抑制过拟合
注: 对CART树剪枝可以有效降低方差
参考文章
【机器学习】决策树(中)——Random Forest、Adaboost、GBDT (非常详细)
GBDT(梯度提升决策树)——来由、原理和python实现
「五分钟机器学习」集成学习——Ensemble Learning
GBDT的原理、公式推导、Python实现、可视化和应用
Manning Editors出版的《Grokking Machine Learning》一书的存储库
What is AdaBoost? Friendly explanation with code!
原文采用 CC BY-SA 4.0,参考资料链接保留在正文中。