基于sklearn的鸢尾花分类实验
(更新于 )
同步自我的 CSDN 原文:基于sklearn的鸢尾花分类实验。原文更新时间:2025-11-05 18:38:33。保留原文内容与代码,配图已保存到本站。
一、导入必要的库
matplotlib .pyplot 和seaborn画图
np 和 pandas 用于处理数据
sklearn 机器学习 库,导入数据、数据集划分、 分类模型 (KNN)、评估工具内置算法
二、加载数据集
有150个样本,每个样本四个特征值[sepal length, sepal width, petal length, petal width]
三种类别 [‘setosa’ ‘versicolor’ ‘virginica’]
图一 数据分布
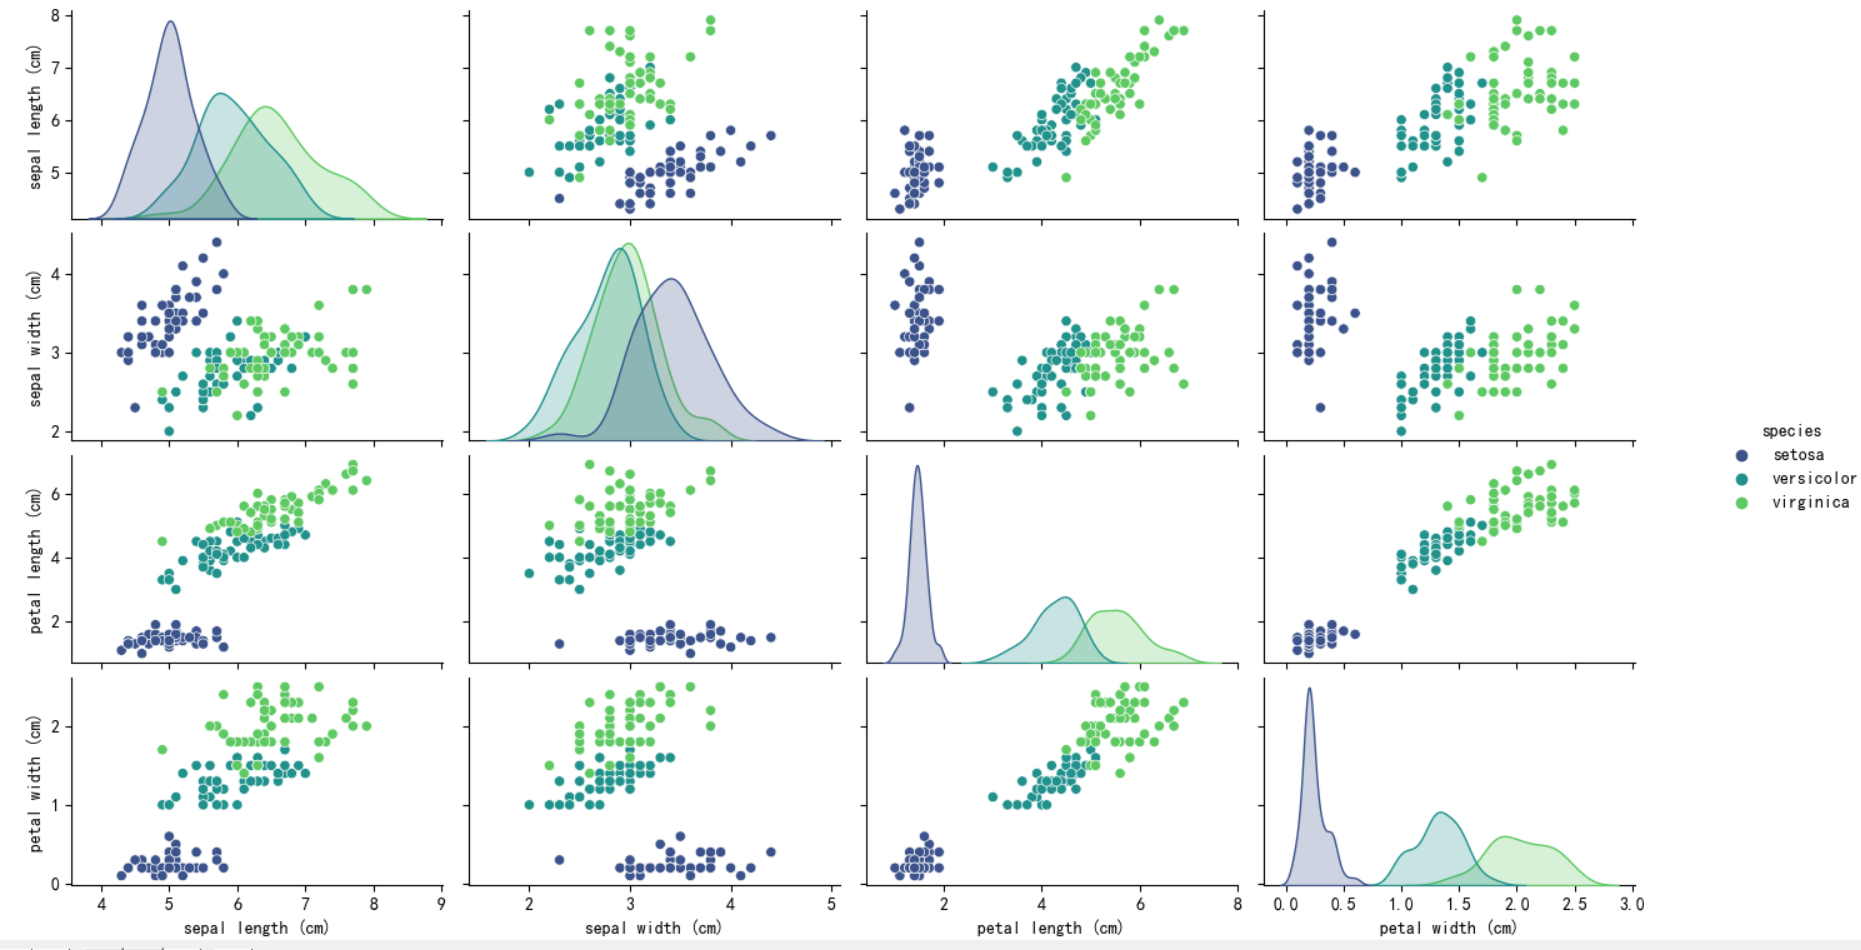
**注:**将数据转换成 Pandas DataFrame格式,便于 seaborn 画图
三、划分训练集和测试集
7比3
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)
四、选择并训练模型 (KNN)
用knn算法设置k=3
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
原理:选定一个样本,从周围选择最近的3个样本,投票选出占比最多的种类,就是该选定样本的类别
五、训练结果
图二 对整个数据集的分类结果
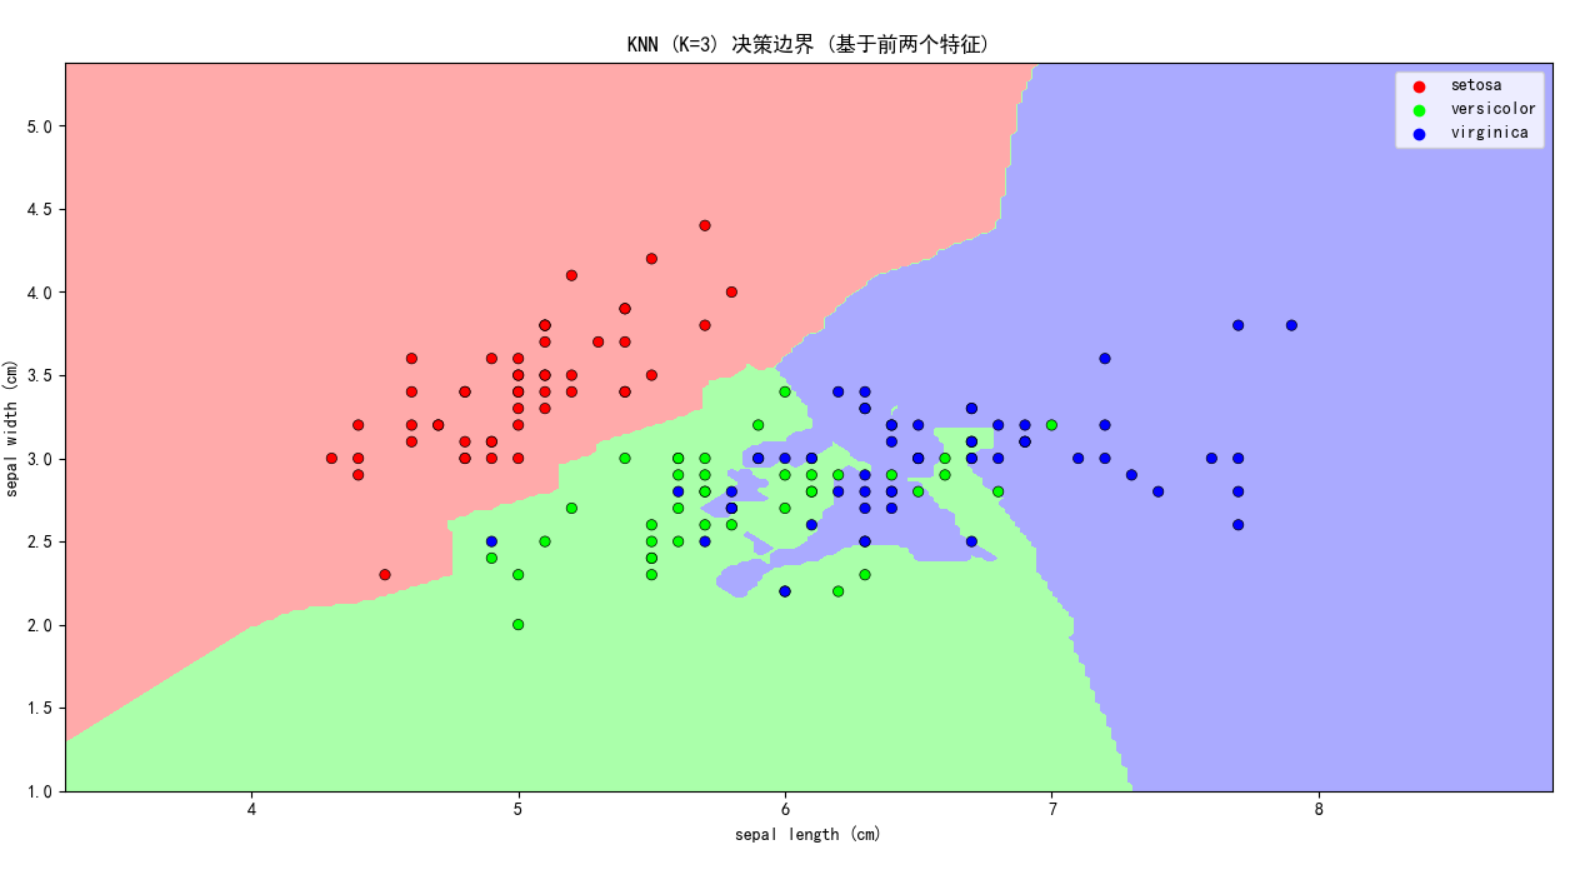
六、进行预测和评估
模型在测试集上的准确率 : 0.9556
accuracy = accuracy_score(y_test, y_pred)
# matplotlib 和 seaborn 用于数据可视化,画图用的
import matplotlib.pyplot as plt
import seaborn as sns

# 配置 matplotlib 的环境
# 设置字体为黑体,解决中文乱码问题
plt.rcParams['font.sans-serif'] = ['SimHei']
# 解决负号'-'显示为方块的问题
plt.rcParams['axes.unicode_minus'] = False

# np 和 pandas 用于处理数据,特别是数值和表格数据
import numpy as np
import pandas as pd
from matplotlib.colors import ListedColormap

# sklearn 核心的机器学习库,导入数据、数据集划分、分类模型(KNN)、评估工具
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# 1. 加载数据集
iris = load_iris()
X = iris.data
y = iris.target

# 打印数据集信息
print(f"特征数据 (X) 形状: {X.shape}")
print(f"目标标签 (y) 形状: {y.shape}")
print(f"目标类别名称: {iris.target_names}\n")

# 将 sklearn 加载的数据转换为 Pandas DataFrame
# sklearn 加载的数据是 NumPy 数组格式,虽然适合计算,但不太利于观察和绘图
# 带有列名和索引的强大表格结构
iris_df = pd.DataFrame(data=X, columns=iris.feature_names)
# 添加一个 'species' 列,用于区分鸢尾花的种类
# iris.target 是数字 (0, 1, 2),我们将其映射为实际的物种名称
iris_df['species'] = pd.Categorical.from_codes(iris.target, iris.target_names)

# --- 可视化 1: 数据分布 ---
print("正在生成数据分布图...")
sns.pairplot(iris_df, hue="species", palette="viridis")
plt.suptitle("鸢尾花数据集特征分布 (Pair Plot)", y=1.02)
plt.show()


# 2. 划分训练集和测试集 (后面的代码保持不变)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

print(f"训练集样本数: {X_train.shape[0]}")
print(f"测试集样本数: {X_test.shape[0]}\n")

# 3. 选择并训练模型 (K-Nearest Neighbors, K=3)
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)
print("模型训练完成。\n")

# 4. 进行预测
y_pred = knn.predict(X_test)

# 5. 评估模型性能
accuracy = accuracy_score(y_test, y_pred)
print(f"模型在测试集上的准确率 (Accuracy): {accuracy:.4f}")

print("\n--- 详细分类报告 ---")
print(classification_report(y_test, y_pred, target_names=iris.target_names))

# --- 可视化 2: 决策边界 (以两个特征为例) ---
# 为了在二维平面上可视化,我们只选择前两个特征:花萼长度和花萼宽度
X_for_viz = X[:, :2]
knn_for_viz = KNeighborsClassifier(n_neighbors=3)
knn_for_viz.fit(X_for_viz, y)

# 创建一个网格来绘制决策边界
# 1. 定义网格的范围 (x 和 y 轴的最小/最大值)
x_min, x_max = X_for_viz[:, 0].min() - 1, X_for_viz[:, 0].max() + 1
y_min, y_max = X_for_viz[:, 1].min() - 1, X_for_viz[:, 1].max() + 1

# 2. 使用 np.meshgrid 生成网格点坐标矩阵 xx 和 yy
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.02),
                     np.arange(y_min, y_max, 0.02))

# 3. 对网格中的每个点进行预测,得到 Z
Z = knn_for_viz.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# 定义颜色映射
cmap_light = ListedColormap(['#FFAAAA', '#AAFFAA', '#AAAAFF'])
bold_colors = ['#FF0000', '#00FF00', '#0000FF'] # 供 seaborn 使用的颜色列表

# 绘制决策边界和数据点
print("\n正在生成决策边界图...")
plt.figure(figsize=(8, 6))

# 使用 xx, yy, Z 绘制背景颜色
plt.contourf(xx, yy, Z, cmap=cmap_light)

# 绘制散点图
sns.scatterplot(x=X_for_viz[:, 0], y=X_for_viz[:, 1], hue=iris.target_names[y],
                palette=bold_colors, alpha=1.0, edgecolor="black")

plt.xlim(xx.min(), xx.max())
plt.ylim(yy.min(), yy.max())
plt.title("KNN (K=3) 决策边界 (基于前两个特征)")
plt.xlabel(iris.feature_names[0])
plt.ylabel(iris.feature_names[1])
plt.legend(loc='upper right')
plt.show()

# --- 可视化 3: 混淆矩阵 ---
cm = confusion_matrix(y_test, y_pred)

print("\n正在生成混淆矩阵图...")
plt.figure(figsize=(8, 6))
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',
            xticklabels=iris.target_names,
            yticklabels=iris.target_names)
plt.title('KNN (K=3) 混淆矩阵')
plt.ylabel('真实类别')
plt.xlabel('预测类别')
plt.show()
原文采用 CC BY-SA 4.0,参考资料链接保留在正文中。